Суперинтеллект: разметка собственного фотоархива
У компании накопились фотографии собственных изделий: общие виды, отдельные узлы, разные исполнения и повторные кадры одного экземпляра. Прежде чем заказывать модель распознавания, полезно подготовить понятный набор примеров и проверить его разметку. В направлении «Суперинтеллект» можно согласовать приложение для такой работы: собрать разрешённые снимки, предложить метки, показать спорные случаи сотруднику и выпустить зафиксированную версию набора. Это отдельный результат проекта, предшествующий обучению или испытанию выбранной модели.
Запросить проект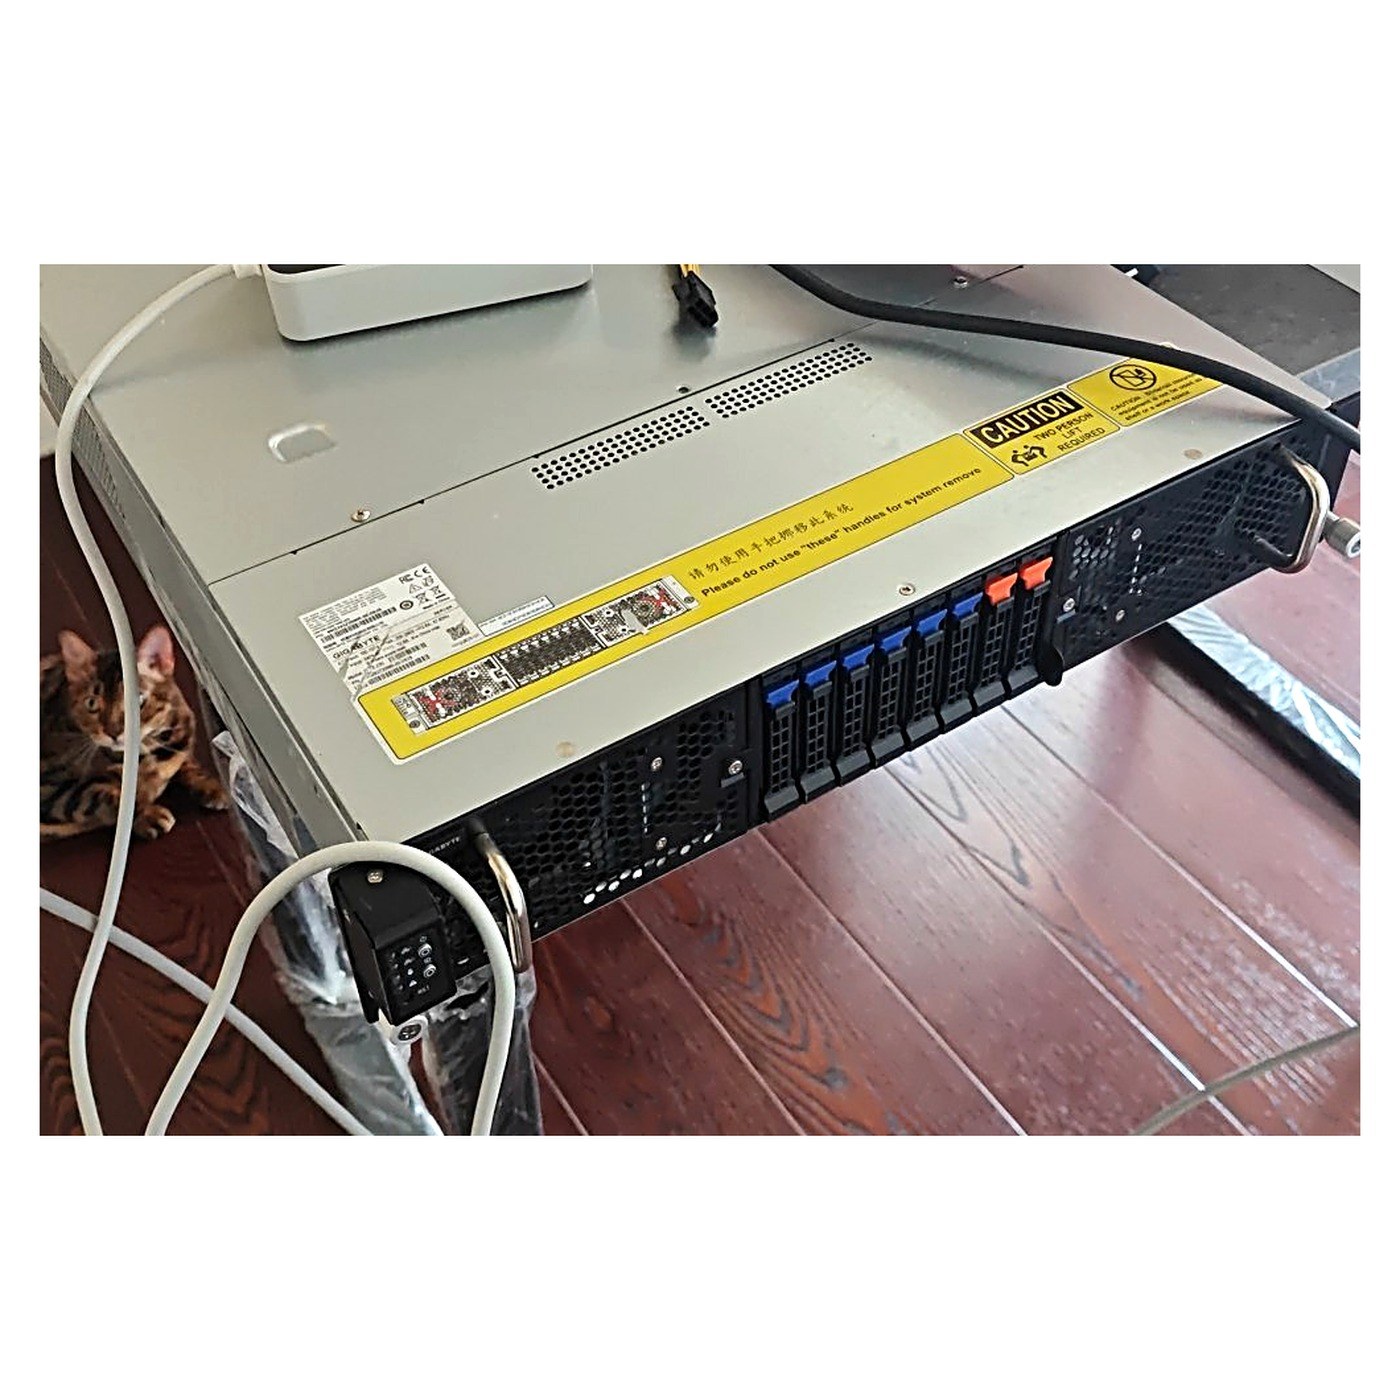
Сначала определить вопрос к одной фотографии
Один архив можно использовать для разных задач. «Какое семейство изделия показано?» отличается от «где находится нужный узел?» и «читается ли обозначение исполнения?». Для первого пилота выберите один вопрос и опишите, какой ответ вообще допустимо получить из снимка. Нельзя требовать различения двух модификаций, если видимый ракурс не показывает их отличительный признак.
Результатом может быть каталог изображений с идентификатором, разрешённой меткой, статусом проверки и ссылкой на оригинал. Если нужна область на изображении, её разметку и формат согласуют отдельно. Название папки «готовое» не объясняет, что именно подтверждено. Словарь классов и инструкция сотруднику должны существовать до массового распределения файлов.
Классы должны быть понятны двум разметчикам
Возьмём условные классы «панель», «кабельный узел» и «корпус». Для каждого полезны несколько подходящих примеров и снимки, которые выглядят похоже, но в класс не входят. Фото панели внутри открытого корпуса требует заранее выбранного правила: один главный класс, несколько меток или отдельная очередь для рассмотрения.
Начните с небольшой общей партии, которую независимо посмотрят два компетентных сотрудника. Их расхождения показывают, где инструкция оставляет выбор неясным. После обсуждения уточняют правило и фиксируют его редакцию. Согласие разметчиков не гарантирует качество будущей модели, но помогает не строить испытание на метках, которые сама компания понимает по-разному.
Предложение ИИ сохранять отдельно от решения человека
Приложение может предлагать класс или порядок просмотра похожих случаев. В интерфейсе должны различаться предложение программы, подтверждённая метка и отсутствие достаточных признаков. Автоматически записанное предположение не следует выдавать за проверенное знание о товаре.
Для сомнительного снимка сотруднику нужны оригинал, доступное описание экземпляра и правило класса. Если дополнительные сведения использованы при подтверждении, это отмечают отдельно: будущая модель может не получить такого описания на входе. Нечитаемую маркировку или скрытое исполнение нельзя восстановить как достоверный факт только из соседнего кадра, незаметно превратив его содержание в ответ по одиночной фотографии.
Повторные кадры связать с одним экземпляром
Пять ракурсов одного устройства дают полезную информацию, но не равны пяти независимым устройствам. Копия снимка с другим размером и фрагмент исходной фотографии тоже могут создавать повтор. Поэтому в наборе полезен идентификатор группы: экземпляр, серия съёмки или иной согласованный объект происхождения.
При разделении материалов для настройки и итоговой проверки связанные снимки держат в одной группе. Иначе проверка может оказаться проверкой уже знакомого экземпляра в соседнем ракурсе. В документации scikit-learn GroupKFold описан подход с непересекающимися группами. Он иллюстрирует программный механизм, но правильный смысл группы для ваших изделий определяет команда проекта.
Группировка не заменяет поиск дублей и не гарантирует независимость любого архива. Сотруднику нужно проверить способ формирования групп, особенно при пересъёмке того же изделия в другую дату. Итоговый набор для проверки сохраняют отдельно; его метки не используют для подгонки очередного варианта программы.
Не потерять происхождение при экспорте
Для каждого изображения оставляют исходный идентификатор, файл, метку и редакцию инструкции. В документации Hugging Face Datasets показаны структура ImageFolder и отдельные метаданные для изображений. Это возможный формат обмена, а не требование публиковать архив компании в облаке или готовая программа разметки.
Согласуйте локальный экспорт, права на использование снимков и доступ сотрудников. При исправлении класса выпускают понятную версию набора, сохраняя связь с исходниками. Простое переименование папки без истории решения затрудняет последующее сравнение. Для испытания полезно знать, какие снимки и правила использованы, а не только общее число файлов.
Что принять до обучения модели
Проверяемый результат первого этапа — согласованный словарь, инструкция, размеченная партия, список нерешённых случаев и экспорт с понятным разделением групп. Посчитайте пропущенные изображения, противоречивые метки и случаи, для которых фотографии недостаточно. Обученная модель и её показатели в этот результат автоматически не входят.
В AlphaSolutions можно запросить AI Server Manager 256 под такой проект. Цена, фактические компоненты, состояние и наличие уточняются; число 256 не подтверждает RAM или видеопамять. Необходимость GPU и конфигурацию определяют после выбора операций и пробной нагрузки. Для варианта с модифицированными CMP 170HX совместимость среды и выбранной модели проверяют на конкретной машине.
В предложении отдельно перечисляют оборудование, приложение, правила разметки, подготовку данных, лицензии и сопровождение. Обучение и последующие испытания согласуют самостоятельным этапом. Пришлите разрешённые примеры, количество снимков, типы изделий, число сотрудников и город получения: рассчитаем состав проекта, подтвердим срок и доставку по России или в Казахстан.
Сервер и состав проекта
AI Server Manager 256
Цена по запросу. Фактические CPU, RAM, GPU, память каждого ускорителя, накопители, состояние и совместимость выбранных программ согласуются в спецификации. Число 256 не подтверждает память. Приложение, разметку, лицензии, обучение и сопровождение выделяют отдельными этапами. Наличие, срок и доставка по России и Казахстану подтверждаются предложением.
Запросить проектДругие собственные варианты для сравнения по спецификации: AI Server Manager 128 и AI Server Manager 384.
Первичные источники: Hugging Face Datasets: ImageFolder и метаданные изображений; scikit-learn GroupKFold: непересекающиеся группы. Это примеры подходов к формату набора и разбиению групп; предустановка, обучение модели и испытание на предлагаемой машине ими не подтверждаются.